
要点(30秒で): 推論の高速化を「メモリを速くする」ではなく「重みを回路に固定する」で解こうとする流派が、ついに大手に買われた。あなたの推論コスト計算の前提——GPUは何でも動く、だから汎用が正義——が数年内に揺らぐ可能性がある。まずは自社の推論ワークロードのうち「モデルを半年以上変えない部分」がどれくらいあるかを棚卸ししておきたい。
AMDが2026年8月6日、カナダ・トロントのAIチップスタートアップTaalasを買収する契約を結んだと発表した。買収額は非公開、規制当局の承認を条件に2026年第4四半期のクローズを見込む。発表当日、AMD株は1.5%ほど上げた。
金額が伏せられた買収は、普通ならそれほど大きな話ではない。ただしこの一件は、AI推論という産業の一番深いところにある前提——チップはプログラマブルであるべきだ——に正面から逆らう技術を、時価総額数千億ドル級の企業が抱え込んだという意味で、静かに異様である。
何が起きたか
Taalasは2023年創業。CEOのLjubisa Bajicは、AIチップ設計会社Tenstorrentを率いていた人物で、しかもAMDの出身でもある。古巣に戻る形での売却、と言えなくもない。
同社が作っているのは、本人たちの言葉で「モデル特化型集積回路(MSIC)」。GPUのように「どんなモデルでも動かせる汎用の計算機」を作るのではなく、特定のモデル1本のためだけに、その重みごとチップを焼く。
資金調達は2024年のステルス脱出時に5,000万ドル、2026年2月にQuiet Capital、Fidelity、半導体投資家のPierre Lamondらから1億6,900万ドルを追加し、累計はおよそ2億1,900万ドルに達していた。直近ラウンドから半年での売却である。
AMD側のコメントは、AI部門を統括するSVPのVamsi Boppanaによるもので、「あらゆるAIワークロードに対して適切な計算ソリューションを選べる柔軟性を顧客に提供する、フルスタックのAIプラットフォームを構築している」という趣旨のものだった。要するに、GPU一本槍ではもう戦えない、という宣言に近い。

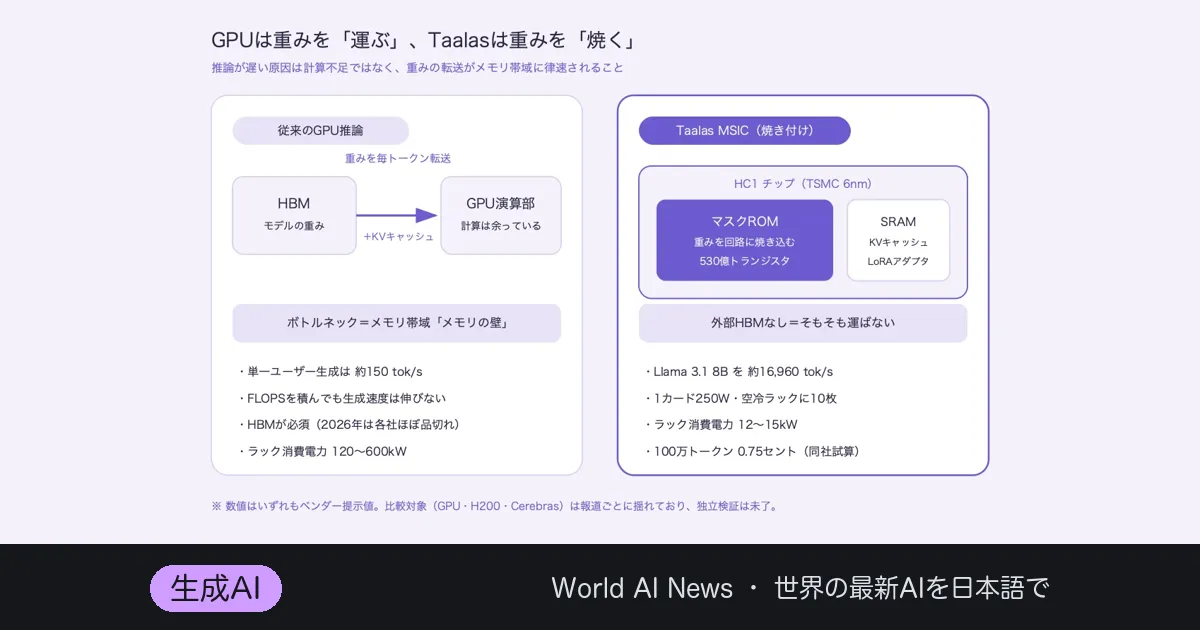
図1:GPUは重みを「運ぶ」、Taalasは重みを「焼く」——メモリの壁を回避する構造の対比
「重みをシリコンに焼く」とは何をすることか
いまのLLM推論がなぜ遅いのかを一言で言えば、計算が足りないからではなく、重みを運ぶのが間に合わないからだ。トークンを1つ生成するたびに、GPUはHBM(広帯域メモリ)からモデルの重みを読み出し、KVキャッシュも一緒に引っ張ってくる。
この工程は演算ではなくメモリ帯域に律速される。だからFLOPSをいくら積んでも、単一ユーザーの生成速度はほとんど伸びない。業界がこれをメモリの壁と呼んでいるのは、比喩というより物理的な事実の記述に近い。
Taalasの発想は乱暴なほど直接的で、そもそも運ぶのをやめる。重みをHBMに置かず、チップ上のマスクROMとして回路そのものに焼き込んでしまう。同社はこの領域を「リコール・ファブリック」と呼び、その隣にKVキャッシュとLoRA的な微調整アダプタを置くためのSRAM領域を並べる構成にしている。
報じられているところでは、HC1と名付けられた最初のテストチップはLlama 3.1 8Bの全重みを530億トランジスタ規模のマスクROMに収め、トランジスタ1個が4ビットの重みを保持しつつ、その乗算まで担う。記憶と計算を分けるという半導体の大前提を、この一点で放棄している。
重みが動かないので、HBMは要らない。HBMが要らないので、消費電力も冷却も一気に軽くなる。MarkTechPostの2月の記事では1カード250Wとされ、標準的な空冷ラックに10枚入るという説明がなされていた。液冷のための設備改修が不要になる、という主張の根拠はここにある。

図2:モデルごとに作り直すのは上位2層だけ——重みの受領から出荷まで約2カ月という主張
上位2層だけ差し替える、という回り道
「モデルごとにチップを作る」と聞いて誰もが最初に思うのは、そんなものは経済的に成り立たない、である。フルカスタムASICの設計と製造には通常、数千万ドルと1年以上がかかる。モデルが半年で入れ替わる市場で、それは自殺行為に見える。
Taalasはここで、2000年代前半の半導体業界が使っていた構造化ASICの流儀を持ち出した。チップの100層以上あるレイヤーのうち、モデルごとに変えるのは上位2層の金属配線だけ。残りは共通の土台として使い回す。
TSMCと組んだこの設計フローによって、モデルの重みを受け取ってから実際に載せられる推論カードを出荷するまで、およそ2カ月で回せると同社は主張している。この数字が本当なら、「モデル特化」の最大の弱点だったターンアラウンドが、四半期のリズムに収まる。
同社はさらに、モデルをシリコンに焼く費用は、フロンティアモデルをゼロから訓練する費用のおよそ100分の1だと見積もっている。訓練に何億ドルもかけたモデルなのだから、それを最速で動かす専用ハードに数百万ドル追加するのは合理的だ——という論法である。

図3:焼いていいモデル/まだGPUに残すモデル——自社の推論を仕分けるチェックリスト
16,960トークン/秒という数字の読み方
性能の主張は派手だ。HC1はTSMCの6nmプロセスで製造され、Llama 3.1 8Bをおよそ16,960トークン/秒で捌いたとされる。単一ユーザーのデコード時にH100が出す数字がおおむね150トークン/秒前後だとすれば、桁が2つ違う。
ただし、比較の「相手」が報道ごとに揺れている点は正直に指摘しておきたい。The Registerは2月発表時点で「GPUの48倍、Cerebrasの8.5倍」と伝え、SiliconANGLEは「H200の73倍を10分の1の電力で」と書き、Forbesの2月の記事は14,357トークン/秒という別の数値とともに「Cerebrasのウェハースケールエンジンの10倍」「GPUに対して2桁」と紹介している。
数字そのものが嘘だと言いたいのではない。バッチサイズ、量子化の深さ、コンテキスト長、単一ユーザーか同時多数かで、この種の指標はいくらでも動く。ベンダー提示のベンチマークが独立検証を経ていないのは、この分野ではむしろ通常運転だ——Qwen3.8 Maxが首位に立ち、いま3位にいる——揺れる指標で見たとおり、指標は立ち位置とともに動く。
もっとも、コスト側の主張のほうが実務家には効くかもしれない。Forbesが伝えたTaalasの試算では、Llama 8Bの推論単価は100万トークンあたり0.75セント、対するGPU換算は20〜49セント。ラック消費電力は12〜15kWで、GPUラックの120〜600kWと比べれば別世界だ。4年のTCOで設備投資を60〜75%削減できる、という話になっている。
HBMが2026年を通してSK hynix・Samsung・Micronの三社ともほぼ売り切れ状態にあることを思えば、「HBMを一切使わない推論チップ」という一点だけでも、いま最も欲しがられる性質ではある。
なぜAMDが、いま買ったのか
AMDにとってこれは、ここ9カ月で3件目のAI関連買収だ。2025年11月にMK1、2026年6月にMext、そして今回のTaalas。単発の思いつきではなく、明確に手数を打っている。
背景には、AMDが2026年に入って積み上げた巨大なコミットメントがある。OpenAIとは2025年10月に6ギガワット規模の複数世代契約を結び、MI450の最初の1ギガワット分が2026年後半から立ち上がる。Metaとも2026年2月に6ギガワットの拡大パートナーシップを発表し、Anthropicやマイクロソフトの名前も並ぶ。
そして今年のAdvancing AIで投入したのが、ラックスケールのHelios。AMDはこれをNvidiaのRubin NVL72に対して「ドルあたりのトークンが30%多い」と位置づけている。つまりAMDは、性能ではなく単価で殴る戦い方をすでに選んでいる。
その延長線上にTaalasを置くと、絵が見えてくる。The Registerは、プロンプト処理(プリフィル)をGPUに任せ、トークン生成をTaalasチップに投げる分業や、段階的に置き換えていく展開の可能性を挙げている。汎用の柔らかさと専用の速さを、同じラックの中で使い分けるという構図だ。
これは、モデルルーティングで安く済ませようとした試みが直面した難しさ——Fable級を1/3のコストで——「Echo」が突きつけた”賢いルーター”の幻想——を、ソフトウェアではなくハードウェアの層で解こうとする試みでもある。
推論チップ市場は、この1年で一気に畳まれた
視野を広げると、Taalas買収は孤立した事件ではない。2025年12月、NvidiaがGroqの推論技術について約200億ドルの非独占ライセンス契約を結び、創業者Jonathan Rossら経営陣がNvidiaに移籍した。買収ではなく実質的なアクハイアという形を選んだのは、独禁法の壁を回避するためだと広く読まれている。
Intelも動いていた。SambaNovaを約16億ドルで買収する交渉が2025年末に報じられたが、これは不成立に終わり、2026年2月に3億5,000万ドルの出資と複数年のパートナーシップという形に落ち着いている。SambaNovaはその後、独自に大型調達を実施した。
一方で、Transformer専用ASICを掲げるEtchedは2026年6月30日にステルスを脱し、TSMCのN4Pで作ったSohuの実チップと8チップ構成のラックシステムを公開。累計約8億ドルを調達し、10億ドル超の契約を確保、最初のラックはこの夏から出荷するとしている。Cerebrasも年明けにIPOを完了させた。
推論ワークロードがAI計算全体の3分の2を占めるようになった——という業界推計が正しいなら、この総取り合戦は当然の帰結だ。訓練の世界ではNvidiaの牙城は当面揺るがない。しかし推論は、レイテンシと電力と単価という、専用回路が得意とする指標で評価される。
面白いのは、大手3社の解き方が微妙に違うことだ。Nvidiaは超低遅延のLPU技術を人ごと吸収し、Intelは資本提携で足場を確保し、AMDは最も過激な「焼き付ける」流派を丸ごと買った。汎用性をどこまで捨てられるかについて、賭け方が割れている。
最大の弱点は、技術ではなく暦にある
この技術のリスクは、実のところ単純だ。焼いたら、変えられない。
Llama 3.1 8Bを焼いたチップは、Llama 3.1 8Bしか動かさない。そのモデルが世代交代したとき、ソフトウェアなら差し替えて終わりの作業が、ここでは物理的な再製造になる。上位2層だけとはいえ、テープアウトとファブの待ち行列は現実に存在する。
言語モデルの意味あるチェックポイントが数カ月おきに出てくる市場で、常に一世代前のモデルを出荷し続けるハードウェア会社になる——これが懐疑派が「致命的」と呼ぶモデルの陳腐化リスクである。Forbesも2月の時点で、複数SKUを抱える運用の煩雑さと、データセンター側がモデル固定の設備を嫌う可能性を指摘していた。
製造面の懸念も残る。大きなダイ、独自の製造フロー、頻繁なリスピン。この三つが揃うと歩留まりが読みにくくなり、量産規模では粗利が想定より薄くなりやすい。2カ月ターンアラウンドという主張も、少量の試作ではなく量産ボリュームで実証されたわけではない。
もっとも、AMDの傘下に入ったことでこの計算式は少し変わる。スタートアップ単独なら「特定モデルに賭けて外れたら終わり」だが、GPUを持つ会社の一部門なら、外れた分をGPUで受け止められる。買い手として、これ以上ないほど理屈の通った相手ではある。
これからどうなる
次の焦点はHC2だ。約200億パラメータ級のモデルを対象とし、50台のアクセラレータをパイプライン並列で束ねれば1兆パラメータ級まで届く、という構想が示されている。Forbesの2月時点の記述では、HC2は密度を上げ、独自の激しい量子化ではなく標準的な4ビット浮動小数点形式を採るとされ、2026年冬が目標だった。
買収のクローズが第4四半期、HC2の目標が同じ冬。この二つが重なる時期に、AMDが何をHeliosのロードマップに組み込むかが最初の答え合わせになる。
現実的な着地点は、たぶん「全部を焼く」ではない。使用量が突出して多く、かつ長期間固定される少数のモデル——たとえば大規模サービスの既定モデルや、埋め込み・リランキングのような裏方——だけが焼かれ、残りはGPUに残る。専用と汎用の境界線がどこに引かれるかが、今後1〜2年の見どころになる。
そしてもう一つ。焼くという行為は、モデルを事実上インフラとして固定するということでもある。データセンターの設備投資が返済可能かどうかが問われている局面で——AI崩壊のあとに残るもの——「年2兆ドル」を返せない industry の末路で扱ったとおりだ——償却期間の途中でモデルが陳腐化する資産を積む判断は、財務的にもかなり尖っている。
日本・個人開発の視点
日本の読者にとって、この話は二方向から効いてくる。
一つは供給側。ラピダスは2026年3月に2nmのPDK提供を始め、年内に顧客設計のテストチップ製造に入る計画で、量産は2027年後半を狙う。4月には千歳にチップレット向けの後工程拠点RCSが立ち上がった。構造化ASIC的な「土台は共通、上位層だけ差し替え」という設計思想は、最先端ノードの量に勝てない後発ファウンドリにとって、むしろ相性が良い戦い方でもある。日本が推論専用シリコンでどこに賭けるのかは、これから議論されるべき論点だ。
もう一つは、個人開発者や小規模チームにとっての含意だ。焼き付けチップは当面データセンターの話であって、手元に来るものではない。ただし「重みをどこに置くか」で速度と電力が決まるという原理は、規模を問わず同じである。マイコンのフラッシュに重みを逃がして$8のハードでLLMを動かした話——$8のマイコンでLLMが動いた——重みをフラッシュへ逃がすGemmaの技——と、530億トランジスタに重みを焼くTaalasは、スケールが違うだけで発想の根は同じ場所にある。
実務的に今できることがあるとすれば、自分のプロダクトの推論のうち、モデルを頻繁に入れ替える部分と、半年以上動かさない部分を分けて把握しておくことだろう。その切り分けは、専用シリコンが降りてくる前から、量子化・蒸留・キャッシュ設計の判断にそのまま使える。
要点まとめ
- AMDが2026年8月6日、トロントのTaalasを買収する契約を発表。金額非公開、規制承認を経て2026年第4四半期クローズ予定。同社はここ9カ月でMK1、Mextに続く3件目のAI買収となる。
- Taalasはモデルの重みをHBMではなくマスクROMとしてシリコンに焼き込む「モデル特化型IC」を開発。テストチップHC1はTSMC 6nmでLlama 3.1 8Bを約16,960トークン/秒で処理したとされる。
- 100層超のうちモデルごとに変えるのは上位2層のみで、重みの受領から出荷まで約2カ月というのが同社の主張。1カード250W、空冷ラックで完結し、HBMを一切使わない。
- 最大のリスクはモデルの陳腐化。焼いたチップは別モデルを動かせず、再製造が必要になる。性能主張も比較対象が報道ごとに揺れており、独立検証は未了。
- 背景には推論チップ市場の急速な再編がある。Nvidia-Groqの約200億ドルのライセンス契約、Intel-SambaNovaの交渉決裂と出資への転換、Etchedのステルス脱出とラック出荷開始が、いずれもこの1年に起きた。
🐦⬛ 編集部の視点
ここ数年、AIの進歩は「柔らかさ」の物語だった。何でも動く汎用GPU、何でもこなす基盤モデル、プロンプト一つで振る舞いが変わるシステム。柔らかいほど強い、というのが暗黙の合意だった。
Taalasはその真逆を張る。重みを金属配線として固定し、二度と書き換えない。ソフトウェアだったものを、物にしてしまう。この発想が本当に面白いのは、速いからではなくて、AIのどこかが「もう固めていい」くらいには成熟したと誰かが本気で判断した、その証拠になっている点だ。
もちろん賭けは危うい。モデルは今日も更新される。焼いた瞬間から古びていくチップに数億円を払う気になる顧客が何社いるのか、正直まだ見えない。それでもAMDは買った。しかもHeliosという、単価で殴ると決めた製品ラインを抱えたうえで買った。
問いを一つ置いて締めたい。あなたが日常的に使っているモデルのうち、「向こう2年、これで十分」と言い切れるものはあるだろうか。もし一つでも思い当たるなら、それはもう焼いていいモデルだ。そして焼かれた瞬間、AIは”アプリ”から”設備”に変わる。今回の買収は、その境界線が引かれ始めた場所に立っている。
出典・リンク
- 出典: AMD acquires AI chip startup Taalas to boost inference performance by etching models into silicon(The Register)
- AMD acquires Taalas to hardwire AI models into silicon(SiliconANGLE)
- Taalas Launches Hardcore Chip With ‘Insane’ AI Inference Performance(Forbes / Karl Freund)
- Taalas is replacing programmable GPUs with hardwired AI chips to achieve 17,000 tokens per second(MarkTechPost)
- Taalas emerges from stealth with $50 million in funding(PR Newswire)
- Nvidia buying AI chip startup Groq’s assets for about $20 billion(CNBC)
- Intel partners with AI chip startup SambaNova after acquisition talks reportedly failed(CNBC)
- AMD and Meta Announce Expanded Strategic Partnership to Deploy 6 Gigawatts of AMD GPUs(AMD Newsroom)
- AMD Scales the AI Factory: 6 GW OpenAI Deal, Korean HBM Push, and Helios Debut(Data Center Frontier)
- Inference Becomes the Next AI Chip Battleground(Data Center Knowledge)
- Rapidusは31年度に上場目指す、27年度後半に2nm世代量産(EE Times Japan)

コメントを残す