
要点(30秒で): AIが答えを抱え込み、ウェブへ返る参照が急速に細っている。あなたが書いた記事も、引用した一次資料も、数年後には辿れない側に回る確率が上がっている。まず今日、自分の記事が依拠している外部URLをWayback Machineに手動保存しておくといい。
カナダの雑誌 The Walrus に、公共政策研究者の Vass Bednar による論考が載った。見出しは「Google検索は死につつある。次に来るものはもっと悪い」。
主張はシンプルで、しかし嫌な角度から刺さってくる。検索がAIに置き換わること自体が問題なのではなく、その移行の過程でインターネットの集合的記憶——誰でも辿れる形で残された、人類の共有された記録——が静かに解体されつつある、というものだ。
これは感傷的な懐古の話ではない。数字で追える現象になっている。
「検索が死ぬ」のではなく「返ってこない」
正確に言えば、検索は死んでいない。人々は今も何かを知りたいときに問いを投げている。変わったのは、その問いの答えがどこで完結するかだ。
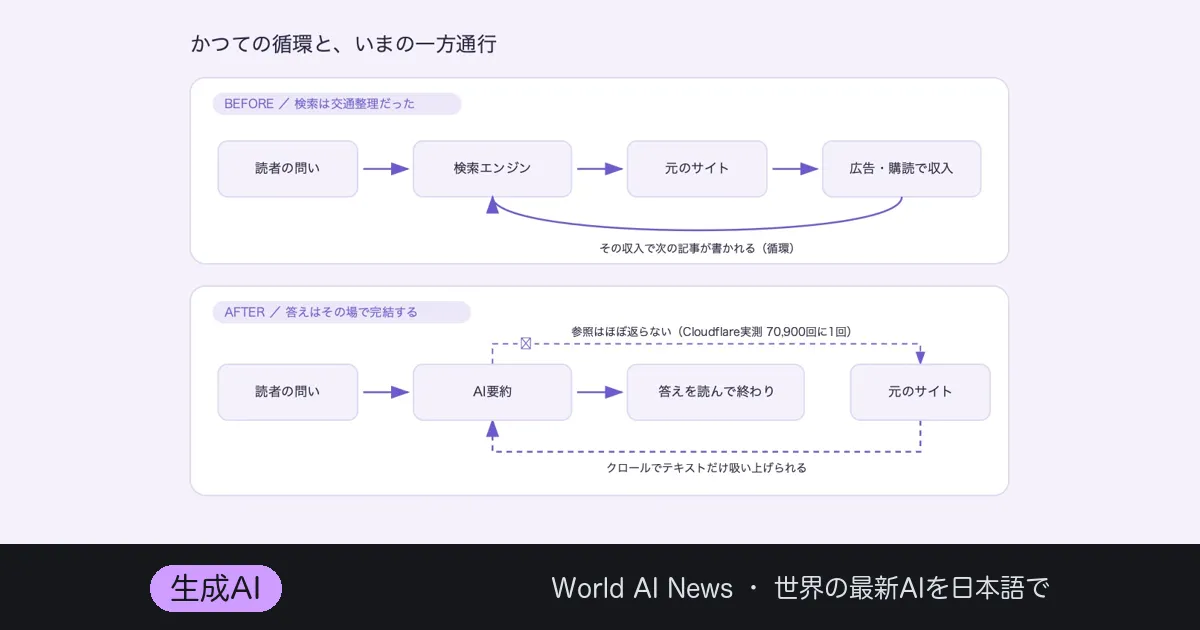
かつての検索は交通整理だった。問いを受け取り、答えがありそうな場所へ人を送り出す。送られた側のサイトは広告なり寄付なり定期購読なりで報われ、その収入で次の記事を書く。この循環がウェブを回してきた。
AI要約は、この交通整理をやめた。答えをその場で組み立てて返し、人はどこへも行かない。元の場所には読者も収入も届かないまま、テキストだけが吸い上げられる。

検索はかつて「交通整理」だった。AI要約はその流れを断ち、テキストだけが上流に吸い上げられる構造になっている。
世界で33%、米国で38%
ロイター・ジャーナリズム研究所が2026年1月に出した年次予測レポート(Nic Newman による、51カ国280名のメディア幹部への調査)に、Chartbeat が2,500以上のニュースサイトから集めた実測値が載っている。
2024年11月から2025年11月の1年で、Google検索経由の流入は世界全体で33%減った。Google Discover 経由は21%減。米国に限れば検索流入は38%減で、より深く削られている。
そして幹部たちは、この先3年でさらに43%減ると見込んでいる。彼らの予想が当たるなら、検索という水源は数年で三分の一以下になる。

流入の減り方は規模で違い、クロールと参照の比率は桁が3〜4つずれる。数字で見た非対称。
小さいサイトから先に枯れる
痛みの配分は均等ではない。Chartbeat のデータでは、1日1万PV未満の小規模サイトは2年で流入が60%減、10万PVまでの中規模は47%減、大手は22%減にとどまる。
つまり体力のない側から先に沈む。大手は交渉力があり、AI企業とライセンス契約を結ぶ余地もある。個人ブログや地方紙にはその窓口すらない。
「AIが情報流通を効率化した」という言い方は、この非対称を隠す。効率化されたのは抽出の側だけだ。

記憶が消える経路は一つではない。腐敗・非参照・削除・自主遮断の4つが同時に効き、その先で誰が困るか。
70,900対1という比率
もっと露骨な数字がある。Cloudflare が2025年6月19〜26日のネットワーク実測から出した「クロール対参照比」だ。AI企業のクローラーが何ページ取っていき、その見返りに何回の参照を送り返してきたかを見る指標である。
Anthropic の Claude は、HTMLページ1回の参照送出に対して約7万1000回のクロール要求を出していた。比率にして70,900対1。同じ期間、Mistral は逆にクロール数の10倍の参照を送り返しており、0.1対1だった。
ただしCloudflare自身が但し書きを付けている。ネイティブアプリ経由の参照には Referer ヘッダが付かないため、実際の参照数は過小に見積もられている可能性が高い。それでも、桁が3つ4つ違う相手を「誤差」で埋めるのは難しい。
この構造は、AI企業が学習用の紙を奪い合っている状況とも地続きだ(AI企業が稀覯本を裁断している——奪い合う「2022年より前」の紙)。素材は要る、しかし素材の供給者を養う仕組みは要らない、という話になっている。
ウィキペディアで起きたこと
被害の輪郭が最もはっきり出たのがWikipediaだ。ウィキメディア財団が2025年10月に公開した分析によると、ボット判定の仕組みを刷新して2025年3〜8月のデータを引き直した結果、人間による閲覧数が前年同月比で約8%減っていた。
財団は原因として二つを挙げている。生成AI検索が答えを直接返すようになったこと、そして若い世代が情報探索をショート動画のプラットフォームで済ませるようになったこと。
Wikipediaの厄介さは、ほぼすべての大規模言語モデルがWikipediaのデータセットで学習している点にある。知識は流れ続けているのに、その源へ戻る道だけが消えていく。編集者も寄付もそこから来ていたのに、である。
消えるほうが速い
そして、リンクは放っておいても腐る。Pew Research Center が2024年5月に出した調査は、2013年に存在したウェブページの38%が2023年10月時点でアクセス不能になっていたと報告している。2013年から2023年のあいだに存在したページ全体で見ても、4分の1は既に消えていた。
ニュースサイトの23%、政府サイトの21%が、少なくとも1本の切れたリンクを抱えている。投稿から数カ月以内に非公開になるツイートは5本に1本近い。
つまりウェブは、AIが来る前から記憶を失い続けていた。AI要約はその上に「そもそも元を見に行かない」という層を重ねただけだ。
FiveThirtyEight、20万時間分の消去
象徴的な事件が去年から今年にかけて起きた。データジャーナリズムの代表格 FiveThirtyEight は、Disney傘下ABCの人員削減(約200名)の一環として2025年3月に閉鎖された。ここまではよくある話だ。
問題はその後で、2026年5月、残されていた記事アーカイブごとネットから消え、fivethirtyeight.com はABC Newsの政治ページへリダイレクトされるようになった。有志が Internet Archive から掘り起こしてインデックス化したところ、38,593本の記事と画像が確認されている。
創業者 Nate Silver は自身のニュースレターで、週20本・1本あたり約20時間という制作実態から、消されたのは20万時間分の労働に相当すると見積もった。企業が一行の意思決定でそれを消せる、という事実のほうが重い。
図書館の扉を、住人が閉めている
では Internet Archive に頼ればいい——と言いたいところだが、そこも塞がりつつある。
AI企業が学習データの取得先としてWayback Machineを使うことを恐れ、報道機関が Internet Archive のクローラー自体をブロックし始めた。Nieman Lab の集計では、2026年5月時点で米国の地方報道340社以上がアクセスを制限しており、そこにはUSA Today系、McClatchy、Advance Local、MediaNews Group、Tribune Publishing といった大手グループ傘下の媒体が含まれる。New York Times は2025年末に archive.org_bot を robots.txt に加え、Reddit も2025年8月にWayback向けのクロールを遮断した。
理屈は分かる。AIに無断で吸われるくらいならアーカイブごと閉じる、と。だが結果として、彼ら自身の記事の未来のコピーも同時に失われる。閉じることが自分の首を絞める構図は、オープンウェイトを巡る議論でも繰り返し見てきたものだ(オープンウェイトの「Kubernetesの瞬間」——遮断は自滅点だ)。
ミュンヘンが引いた線
暗い話ばかりではない。2026年6月、ミュンヘン地方裁判所が世界で初めて、AI要約の中身をGoogle自身の発言として扱う判断を下した。
事の発端は、Googleの AI Overviews が二つの出版社について「詐欺的と見なされることが多い」といった断定を表示したことだ。裁判所が確認したところ、その記述は引用元のどの検索結果にも存在しなかった。AIが加害的な事実を発明していた。
裁判所は、AI要約は第三者コンテンツの引用ではなくGoogle自身の言明であるとして、仮処分を認めた。地裁の仮処分であり最終判決でも拘束力ある判例でもなく、Googleは控訴できる。それでも「生成した文の責任は生成した者にある」という線を司法が一度引いた意味は大きい。
反論——「そこまで壊れていない」という見方
公平のために、逆方向のデータも置いておく。SEO企業 Graphite が2020年1月〜2025年5月の英語記事65,000本を分析した調査では、新規公開記事の52%がAI生成だった一方、Google検索結果に現れる記事のうちAI生成は14%にとどまった。ChatGPTやPerplexityが引用した記事に至っては82%が人間の手によるものだった。
読み方は二通りある。楽観側は「選別は機能している、良い情報はまだ選ばれる」。悲観側は「AIは人間が書いたものを選んで使い、その人間には何も返していない」。
同じ数字が、依存の証明にも搾取の証明にもなる。少なくとも「AIスロップに全部埋め尽くされて終わり」という単純な図式ではない、という点だけは押さえておきたい。
検索を消費者向けの無料サービスとして扱うのをやめる
Bednar の提案はここに着地する。検索とアーカイブを、市場が勝手に維持してくれる無料サービスではなく、道路や水道と同じ重要インフラとして扱え、という主張だ。
論考が挙げる先例はヨーロッパにある。フランス政府は検索エンジンQwantと省庁向けメッセンジャーTchapを自国の基盤として採用し、EU機関はオープンソースへの移行を進めてきた。ドイツの司法判断も、AI出力を野放しにしないという同じ方向を向いている。
カナダに対しては、Library and Archives Canada のような既存機関を軸に据えることを提案している。CANARIE や SchoolNet といった、かつて自前で digital infrastructure を作った経験が土台にある、という文脈だ。
日本・個人開発の視点
日本には国立国会図書館のインターネット資料収集保存事業(WARP)がある。2002年から続く事業で、国立国会図書館法第25条の3にもとづき、2010年4月からは国・自治体などの公的機関サイトを網羅的に収集している。
ただし民間サイトは許諾ベースだ。政党、私立大学、公益法人、震災関連サイトなどが対象で、個人ブログや中小メディアの記事が自動的に残るわけではない。日本語のウェブが失われるとき、それを拾う網は米国のInternet Archiveより粗い。
そして書き手側の実務としては、二つだけやっておく価値がある。ひとつは、記事が依拠する外部URLを公開時にWayback Machineへ手動保存すること。もうひとつは、自分のサイトのバックアップを他人のクラウドだけに預けないこと。閉鎖されるのは常に、閉鎖を決めた人の都合であって、書いた人の都合ではない。
要点まとめ
- ロイター研究所とChartbeatの実測で、Google検索経由のニュース流入は2024年11月→2025年11月で世界33%減、米国38%減。小規模サイトは2年で60%減と、弱い側から先に枯れている。
- Cloudflare の2025年6月実測では、AnthropicのクローラーはHTMLページ1参照あたり約7万1000回のクロールを行っていた(ネイティブアプリの参照は計測外という但し書き付き)。
- ウィキメディア財団は2025年3〜8月データの再集計で、人間による閲覧が前年比約8%減と報告。学習には使われ、訪問は返ってこない構図が固定しつつある。
- Pewの調査では2013年のページの38%が既に消滅。FiveThirtyEightは2026年5月にアーカイブごと削除され、38,593本が有志の掘り起こし対象になった。
- 米国では340社以上の地方報道がInternet Archiveのクロールを制限。AI対策の遮断が、自分たちの記録の保全も同時に止めている。
🐦⬛ 編集部の視点
この論考が怖いのは、悪役がいないところだ。Googleも、AI企業も、アーカイブを閉じた新聞社も、それぞれの合理で動いている。誰も「人類の記憶を消そう」とは思っていない。それでも消える。
そして正直に書くと、この構造の中で我々のようなメディアは加害者側の道具でもある。AIを使って記事を書き、AI経由で読まれ、AIに吸われる。無傷の立場から批評できる場所はもうない。
だからこそ、できることは小さくて具体的な行動しかないと思っている。引用したURLはアーカイブに保存する。一次ソースを本文にきちんと書く。要約で済ませず、元のページを一度は開く。AIの答えを「便利だから」で終わらせず、その答えが誰の書いたものを踏んで立っているのかを一行足す。
あなたが5年前に書いたブログ記事、まだ読める場所にありますか。あるとしたら、それは誰が維持してくれているんでしょう。
出典・リンク
- 出典: As AI eats the web, the internet’s collective memory is disappearing(The Walrus / Vass Bednar)
- Journalism, media, and technology trends and predictions 2026(Reuters Institute / Nic Newman)
- Global publisher Google traffic dropped by a third in 2025(Press Gazette)
- The crawl before the fall… of referrals(Cloudflare Blog、2025年7月)
- New User Trends on Wikipedia(Wikimedia Diff、2025年10月)
- When Online Content Disappears(Pew Research Center、2024年5月)
- Disney erased FiveThirtyEight(Nate Silver)
- More than 340 local news outlets are limiting the Internet Archive’s access to their journalism(Nieman Lab、2026年5月)
- Landmark German ruling declares Google’s AI Overviews are Google’s own words(the decoder)
- AI-written web pages haven’t overwhelmed human-authored content, study finds(Axios / Graphite調査)
- 国立国会図書館 インターネット資料収集保存事業(WARP)

コメントを残す