
要点(30秒で): 「エージェント指標で総合1位」という見出しを見たら、まずその指標が何本のベンチマークでできているかを確認してほしい。Artificial AnalysisのAgentic Indexは、たった2本の等重み平均で、順位は数日で入れ替わっている。自社の採用判断は順位ではなく、1タスクあたりのコストと幻覚率で決めるべきだ。
Alibabaが8月3日に公開したQwen3.8-Maxが、Artificial AnalysisのAgentic Indexで一時的に総合首位に立った、という話が海外で駆け巡った。中国製のモデルがエージェント能力の総合指標でトップを獲る——それ自体は確かに事件だ。
ただ、同じリーダーボードをいま開くと、首位はClaude Opus 5(max effort)の59で、Qwen3.8 Maxは58の3位に落ち着いている。2位もOpus 5(xhigh effort)の58だ。数字が動いたのではなく、指標そのものが動いた。
この記事は「どちらが強いか」を裁定する話ではない。むしろ、順位が数日で入れ替わるような指標を、私たちがどう読むべきかという話だ。
何が起きたか
Qwen3.8-Maxは総パラメータ2.4兆、1トークンあたりの活性パラメータが約950億というMoEモデルだ。活性比はおよそ4%で、Qwen3.5系のアーキテクチャを土台にスケールさせている。コンテキストは100万トークン、最大入力は99.1万トークン(推論を有効にすると98.3万)、最大出力は13.1万トークンという構成になっている。
API価格は入力100万トークンあたり$2.00、出力$6.00。前世代のQwen3.7 Maxの$2.50/$7.50から値下げされた。キャッシュヒット時の入力は$0.25で、素の入力の8分の1になる。
そしてArtificial Analysisの独立計測では、Intelligence Indexが58で186モデル中9位。海外メディアが「US企業ではAnthropicとOpenAIを除いて全部抜いた」と書いたのは、この位置づけを指している。Google、Meta、xAIのどのモデルよりも上、というのが計測時点の評価だった。

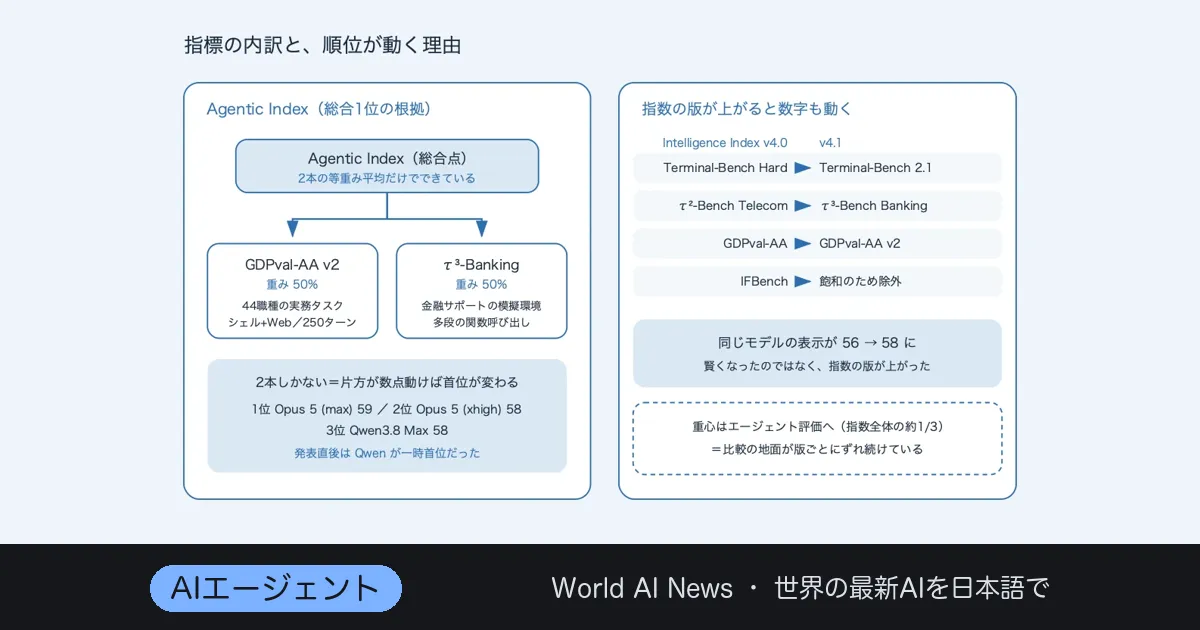
「総合1位」の中身を開ける——Agentic Indexはたった2本の等重み平均で、指数の版が上がれば数字も順位も動く
Agentic Indexは何本でできているのか
ここが今回いちばん大事な部分だ。Artificial AnalysisのAgentic Indexは、複数の多彩なエージェント評価を積み上げた総合点――ではない。GDPval-AA v2と、τ³-Bankingという2本の等重み平均である。
GDPval-AA v2は、44職種の実務タスクをシェルアクセスとWebブラウジング付きの環境で解かせる評価だ。v2では1タスクあたりのターン上限が100から250に拡張され、Eloは人間の専門家を1000として再基準化され、判定は3つのフロンティアLLMの合議で行われる。τ³-Bankingのほうは金融のカスタマーサポートを模した環境で、ナレッジベースを辿りながら複数段の関数呼び出しを正しく積む能力を見る。
どちらも良くできた評価だと思う。しかし2本しかないということは、片方が数点動けば総合順位がひっくり返るということでもある。実際、Hacker Newsのスレッドでは、発表直後にリーダーボードを見ていた読者が、Qwenが首位に出た直後にOpus Maxが上に戻る様子をリアルタイムで書き込んでいた。「たった今メソドロジーを更新した」という指摘も出ている。

「64ターン粘る」という一つの改善が、能力・コスト・正確さの三方向へ同時に波及する
「56」と「58」のあいだ
launch時に各メディアが引用したQwen3.8 MaxのIntelligence Indexは56だった。いまArtificial Analysisのモデルページを開くと58と表示される。モデルが賢くなったのではなく、指数の版が上がったのだ。
Intelligence Index v4.1では、Terminal-Bench HardがTerminal-Bench 2.1に、τ²-Bench Telecomがτ³-Bench Bankingに差し替わり、GDPval-AAがv2になった。フロンティアモデル間で差がつかなくなったIFBenchは飽和として除外された。重みはGDPval-AA v2が20%、Terminal-Bench 2.1が16%、τ³-Banking 14%、Humanity’s Last Exam 12%と続き、エージェント系がおおよそ全体の3分の1を占める設計になっている。
つまりこの指数は、いま「エージェントとして働けるか」を測る方向に急速に重心を移している最中だ。作り手が正直に改訂を重ねているとも言えるし、比較の地面が毎月ずれているとも言える。両方が本当だ。

順位より先に見るべき数字——1タスクを終えるまでの実費。Qwen3.8 Maxは値下げされてなお前世代の倍で、Kimi K3に価格でも性能でも抜かれている
64ターン粘る、という勝ち方
Qwen3.8 Maxのスコア上昇の中身を見ると、性格がよく分かる。GDPval-AAでの平均ターン数が、Qwen3.7 Maxの14に対して64ターンに増えている。前世代の4倍以上、諦めずに手を動かし続けるようになったわけだ。
これは能力向上として本物だ。長時間タスクで途中で投げ出さないことは、エージェントとして最も重要な性質のひとつだから。Qwen自身も、10日以上無人で走り続けたコーディング、500回以上の反復でゲート数を8,298から678まで削ったチップ設計、365日のEC経営シミュレーションで4.16倍のリターンといった事例を挙げている。いずれも自社発表なので割り引いて読む必要はあるが、方向性ははっきりしている。
ただし、粘るということは、トークンを燃やすということでもある。評価全体でQwen3.8 Maxが生成した出力トークンは1.5億で、中央値の7,000万の倍以上だった。
安いはずのモデルが安くなかった
Artificial Analysisはv4.1から、1タスクあたりのコスト・推論時間・出力トークン数を新しく計測項目に加えた。トークン単価ではなく、実際に1つの仕事を終えるまでにいくらかかるかを見る指標だ。
この物差しで見ると、Qwen3.8 Maxは1タスクあたり$1.14。値下げされたにもかかわらず、Qwen3.7 Maxの$0.53からほぼ倍増している。64ターン粘る代償である。
そして同じ表の中で、MoonshotのKimi K3は$0.86でQwenより高いスコアを出している。25%安くて上、ということだ。GLM-5.2は$0.57、DeepSeek V4 Proに至っては$0.04でスコア44を叩き出す。上限性能で言えばClaude Opus 4.8が$1.78で最上位帯だが、この価格差の広がり方を見ると、「どのモデルが一番賢いか」という問いがいかに雑かが分かる。
Hacker Newsで「オープンウェイトのモデルがGPT5.6とほぼ同じコストになっている、$1.14 対 $1.23」と冷めた指摘が出ていたのは、まさにここだ。重みが公開されることの経済的な旨みは、推論トークンを大量に燃やす設計の前では簡単に溶ける。この構図は、以前扱った「Echo」が突きつけた”賢いルーター”の幻想の話と地続きだ。
上がった能力の裏で下がったもの
もうひとつ、順位の見出しからは絶対に見えない数字がある。知識の正確さを測るAA-Omniscienceで、Qwen3.8 Maxは前世代から10ポイント落ちている。そして幻覚率が23%から40%へ跳ね上がった。
これは「知らないことを知らないと言わず、推測で埋める」方向にモデルの性格が動いたということだ。エージェントとして粘り強くなったことと、分からないときに黙らなくなったことは、おそらく同じ訓練の裏表である。長時間タスクを完走させようとすれば、行き詰まったときに止まるより、それらしい答えを置いて先へ進むほうが点になりやすい。
Artificial Analysisの指数では非幻覚率の重みは4%しかない。総合点の上ではほぼ無視できる項目が、実務では最初に事故を起こす項目だったりする。エージェントに社内の業務を任せる話をしているなら、順位よりこの数字を見たほうがいい。
個別ベンチではどう見えるか
総合指数から離れて、個別の数字も並べておく。Terminal-Bench 2.1ではQwen3.8 Maxが86.6で、GPT-5.6 Solの88.8には届かないが、Claude Opus 4.8の84.6は上回る。SWE-bench Proでは67.7で、Fable 5の80.0とはかなりの開きがある。
一方でQwen自身が押しているのはコンピュータ操作の領域だ。OSWorld-Verifiedで86.1を主張しており、これはGPT-5.6 Sol Maxの83.2、Fable 5の85.0を上回るという。自社発表の数字ではあるが、マルチモーダル系はQwenが伝統的に強い領域で、OmniDocBench 1.5でも92.1を出している。第三者の場でも、Vision Arenaで2位、Frontend Code Arenaで4位(Elo 1,668)、Vals Indexではオープンウェイト勢の中で2位(66.1)に付けている。
要するに、万能で首位というより、コンピュータ操作と長時間タスクに尖った勝ち方をしている。速度は逆に弱く、出力64.6トークン/秒は186モデル中80位で、中央値の67.1を下回る。初回応答までは2.57秒。
「開くと言った」ままの重み
そして今回いちばん引っかかるのが、開放の約束だ。Alibabaは今回、Max級のモデルとして初めて重みを公開すると表明した。小型のQwen3.8-27Bも同時に出すという。Max系がずっとクローズドだったことを考えれば、これは戦略の転換である。
ただし8月6日時点で、Hugging FaceにもModelScopeにも公式のモデルカードは出ていない。ライセンスも未公表で、Apache 2.0のような寛容なものになるのか、独自の制限付きになるのかは分からない。公開は「来週」——おおむね8月10日の週——とされている。
この「言ったけど、まだ」の状態は既視感がある。以前取り上げた重みも数字も出さないQwen-Image-3.0のときと同じ構図で、発表と実物のあいだに時差がある。今回は明確に出すと言っている分だけ前進しているが、ライセンス条項を見るまで「オープンウェイト」と呼ぶのは早い。
仮に出たとしても、2.4兆パラメータを自前で回すにはH100かB300が最低8枚必要とされる。個人はもちろん、多くの企業にとっても現実的な選択肢ではない。オンプレで意味を持つのは27Bのほうだ。
実際に使った人たちの温度
ベンチマークと現場の落差についても、率直な声が出ている。Hacker Newsでは「壊れたまま放置する、テストを確実には書かない」「課題の理解を取り違える」という報告や、AnthropicやOpenAIのモデルと比べて「出力品質の分散がかなり大きい」という指摘があった。
面白いのは、それでもQwenへの関心が高い理由が、Qwenの強さそのものではなく、Claude Opus 5への不満だと語られていたことだ。冗長で暗号めいた出力になる、挙動が読めない——そうした苛立ちが、代替を探す動機になっている。乗り換えは性能表ではなく、日々の摩擦で起きる。
コメント欄の総括として印象に残ったのは、「中国は追いついた、ただし実行力にはまだ差がある」「素の知能スコアが収束すれば、あとはブランド戦争になる」という見立てだった。スコアが横並びになるほど、決め手はスコア以外に移っていく。
日本・個人開発の視点
日本の現場でこのニュースをどう使うか。まず、2.4兆パラメータのMax本体を自前で動かす話は、事実上ほとんどの組織にとって関係がない。見るべきは27Bのほうで、これが本当にApache 2.0で出るなら、オンプレ要件のある案件——医療、金融、自治体——での選択肢が一段増える。ライセンスが確定するまで待つのが正解だ。
もうひとつ、社内で「どのモデルを使うか」を決める人に伝えたいのは、順位表を根拠に稟議を書かないほうがいいということだ。この記事で見た通り、Agentic Indexは2本の平均で、指数の版が上がれば数字も順位も動く。代わりに測るべきは、自社の代表的なタスクを10個選んで、各モデルで完走率・1件あたりの実費・間違った断定の頻度を出すことだ。$1.14と$0.86の差は、月に数万タスク回せば無視できない額になる。
そして幻覚率40%という数字を、社内のリスク説明にそのまま使ってほしい。エージェントに権限を渡す議論は、能力の話ではなく「分からないときに止まれるか」の話だからだ。
要点まとめ
- Qwen3.8-Max(総パラメータ2.4兆/活性950億、1Mコンテキスト)が8月3日公開。Artificial AnalysisのAgentic Indexで一時首位に立ったが、現在はClaude Opus 5(max)の59に次ぐ58で3位。
- そのAgentic Indexは、GDPval-AA v2とτ³-Bankingの2本の等重み平均にすぎず、順位は指数の改訂で容易に入れ替わる。
- スコア上昇の中身は「粘り」。GDPval-AAの平均ターン数が14から64へ。その代償で1タスクあたりのコストが$0.53から$1.14へほぼ倍増し、Kimi K3($0.86)に価格でも性能でも抜かれている。
- 知識系は後退。AA-Omniscienceが10ポイント低下し、幻覚率は23%から40%へ上昇した。総合指数での非幻覚率の重みは4%しかない。
- Max級として初のオープンウェイト化を表明したが、8月6日時点で重みもライセンスも未公開。公開は8月10日の週の見込み。
🐦⬛ 編集部の視点
正直に言うと、この件で面白かったのは順位そのものではなく、順位が動くところをみんなが同時に見ていたことだ。Hacker Newsのスレッドで、数分おきに「いまQwenが上」「いまOpusが戻った」と実況が入る。ベンチマークが更新されていく様子をライブで見る時代になった。
そこで気づいてしまうのは、「総合1位」という言葉の軽さだ。2本の等重み平均で決まる王座に、私たちはどれだけの意味を乗せていたのか。しかも今回、順位を押し上げた「64ターン粘る」性質は、そのまま「1タスクの実費が倍になる」性質でもあり、さらに「分からなくても答えを置いてしまう」性質とも隣り合っている。ひとつの改善が三つの顔を持っている。
それでも、Alibabaが初めてMax級の重みを開くと言った意味は小さくない。中国勢がオープンウェイトの最前線を押さえている流れは変わっていないし、Kimi、DeepSeek、GLMが同じ表に並んで価格で殴り合っている光景は、去年には無かったものだ。ただ、約束が実物になるまでは拍手を取っておきたい。前にも同じところで待たされたから。
あなたが次にモデルを選ぶとき、根拠にするのは順位表だろうか、それとも自社の10個のタスクだろうか。ここ数日の出来事は、その問いに対する答えをかなりはっきりさせてくれたと思う。
出典・リンク
- 出典: Artificial Analysis — Agentic Index
- Artificial Analysis — Agentic capabilities leaderboard
- Artificial Analysis — Qwen3.8 Max モデルページ
- Artificial Analysis Intelligence Index v4.1: a shift toward agentic workloads
- MarkTechPost — Alibaba Qwen Releases Qwen3.8-Max
- The Decoder — Qwen3.8 Max catches Claude Opus 4.8 but Kimi K3 still scores higher for 25 percent less
- OfficeChai — Qwen 3.8 Max Scores 56 On Artificial Analysis Intelligence Index
- VentureBeat — Qwen3.8-Max arrives with a bold claim
- Latent Space AINews — Qwen 3.8 Max (2.4T) and 27B
- TestingCatalog — Alibaba released Qwen3.8-Max with open weights coming soon
- Hacker News — Qwen3.8 Max now ranked as the best overall model by agentic index

コメントを残す