
要点(30秒で): ダートマスのAI教材「Phosphor」が期末試験の成績を最大1.30SD押し上げた——数字だけ見ればハーバードの有名研究と並ぶ。だが論文が正直に認めた本当の答えは「効いたのはAIチャットではなく、答えを書かせる検索練習だった」。あなたの学習ツール選びの基準を、機能の派手さから設計の中身へ移すべき合図だ。
この記事の内容(約8分で読めます)
「新しいAI家庭教師が、ダートマスの授業で0.71〜1.30SDの効果量を叩き出した」。Hacker Newsにそんな見出しが並んだ。数字は本物で、しかも大きい。
ただ、この記事で一番おもしろいのは効果量そのものではない。作った本人が論文の中で、その効果が「AIとの対話からは来ていない」と静かに認めているところだ。ここに、いまのAI教育ブームの核心が詰まっている。
誰が、何を作ったのか
論文のタイトルは「Balancing Efficacy and Engagement in Interactive Texts」。著者はダートマスでコンピュータ科学と教育を学ぶ学部生、Jonah Bard。以前はSpaceXでインターンをしていた人物だ。オランダ・ユトレヒトで開かれた対話型教科書のワークショップ(iTextbooks ’26)で発表された。
作ったツールの名前は「Phosphor」。ひとことで言えば、読み物の中に小テストを埋め込んだ対話型の教材だ。ふつうの教科書を読ませる代わりに、要所要所で自由記述の問いを出し、その答えをその場で採点する。
採点しているのはAIだ。論文によれば、学生が書いた答えを固定の基準に照らして評価するのにClaude Sonnet系のモデルを使っている。選択肢を選ばせるのではなく、自分の言葉で書かせて、それをAIが即座に判定する。この「自由記述をスケールさせる」部分こそがAIの担当領域だった。

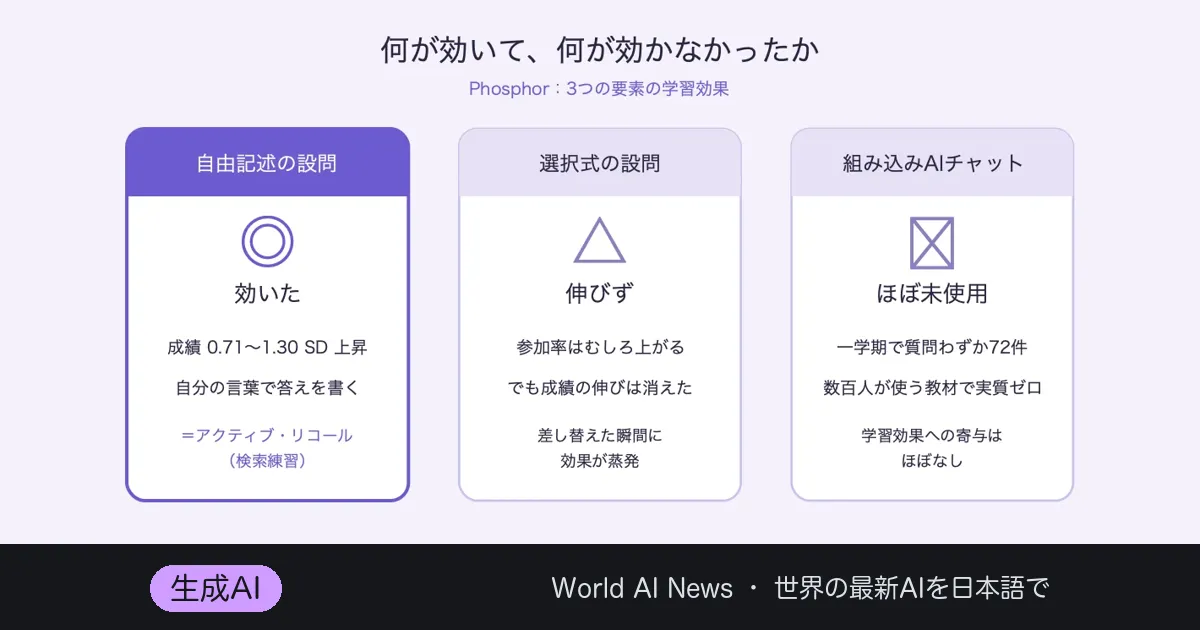
① 何が効いて、何が効かなかったか——Phosphorの3要素を効果で対比
数字は確かに大きい
2026年春学期、統計学入門(MATH 010)の3セクションでパイロット運用された。成績には一切関係しない任意の教材だったにもかかわらず、履修者の90.2%が自主的に使った。
読書の実行率も跳ね上がる。従来この手の課題図書を実際に読む学生はせいぜい1割前後だが、Phosphorでは最低でも48%、多い区分では76%が最後まで到達した。「読ませる」という、教育者が100年間負け続けてきた戦いで、これは相当な数字だ。
そして肝心の成績。教材をフルに消化した学生は、期末試験の成績が事前スコアで調整して0.71〜1.30 SD高かった。1SDというのは、ざっくり言えば中央値の学生を上位16%圏へ押し上げるくらいの差だ。教育介入としては破格に見える。

② 効果を生んだ本当の因果連鎖——AIの役割は「発明」ではなく「安く回すこと」だった
いちばん効いたのは「チャット」ではなかった
ここからが本題だ。Phosphorには当然、質問できるAIチャットも組み込まれていた。ところがそのチャットが一学期で受けた質問は、わずか72件。数百人が使った教材で、この数字は事実上「誰も使っていない」に等しい。
学習効果がはっきり出たのも、自由記述の設問だけだった。選択式の設問では、参加率はむしろ上がるのに成績の伸びは消えた。自由記述をやめて選択肢に差し替えた瞬間、効果が蒸発したのだ。
つまり効いていたのはAIとの会話ではなく、検索練習——自分の頭から答えを引き出す行為そのものだった。認知科学でいうアクティブ・リコール、テストして思い出す負荷が記憶を定着させるという、何十年も前から知られた原理である。
AIの役割は、その「良質だが手間のかかる自由記述採点」を、人間の助教なしで回せるようにしたこと。魔法をかけたのはAIではなく、AIが安く実現可能にした古い教育原理だった。
この構図、どこかで見た。私たちが以前に取り上げたAIに「バグを探せ」は効かない——質を決めるのは”テスト”だという話と、骨格がそっくりだ。AIそのものより、AIを囲む方法論が質を決める。

③ 次に学習アプリを選ぶときのチェックリスト——基準を「機能の派手さ」から「設計の中身」へ
ハーバードの影と「2シグマ問題」
効果量0.71〜1.30という数字を見て、教育界の人はすぐ別の研究を思い浮かべたはずだ。2025年6月にScientific Reportsへ載った、ハーバードの物理コースでのRCTである。
Greg Kestinらが194人の学生を対象に、GPT-4ベースの家庭教師「PS2 Pal」と教室での能動学習を比較したあの研究。効果量は0.73〜1.3σで、1時間あたりの学習量はおよそ2倍。数字の帯がPhosphorとほぼ重なる。
背景にあるのは教育学の有名な難問、Bloomの2シグマだ。1対1の個別指導は集団授業より約2SDも成績を押し上げる——だが人間の家庭教師を全員につけるのは高すぎて不可能。この「2SDの果実」をどうスケールさせるかが半世紀の宿題だった。AIはその答えの最有力候補として期待されている。
面白いのは、ハーバードもダートマスも到達したのが同じ1SD前後で、そしてダートマスの分析は「その多くは対話ではなく設計で説明できる」と示唆した点だ。2シグマを解くのはチャットボットではなく、正しい認知負荷を強制する仕組みかもしれない。
限界は正直に
もっとも、この研究を額面通りには受け取れない。最大の弱点は対照群がないこと。相関はあっても因果とは言い切れない。
任意・無成績の教材を「フルに使った学生」は、そもそも真面目で成績が伸びやすい層かもしれない。この自己選択バイアスを潰す設計にはなっていない。規模も1コース・百数十人と小さく、統計学という科目特有の事情もある。
加えて、AIが答案を自動採点する行為は、EUのAI規制の枠組みでは「高リスク」に触れうる領域だという指摘も論文は添えている。教育現場でAI採点を常用するなら、精度だけでなく制度の話がついて回る。
日本・個人開発の視点
この話が個人開発者に刺さるのは、勝ち筋が「巨大モデルを訓練する」ではなく「良い問いを設計して、その採点をAIに肩代わりさせる」側にあると示したからだ。学部生ひとりが週末に作れる射程に、教育効果の本丸がある。
日本の教材づくりに置き換えても筋がいい。資格試験でも語学でも、選択肢を潰すだけのアプリは山ほどある。だが「自分の言葉で説明させて、その場で赤を入れる」体験は、人手が要るがゆえに希少だった。そこをClaudeやGPTの採点でスケールさせる——参入余地はまだ広く空いている。
要は、光らせるべきは対話UIの派手さではなく、ユーザーに手を動かして思い出させる摩擦のほうだ。摩擦こそが商品価値になる、という逆説がここにある。
要点まとめ
- ダートマスの学部生が作ったAI教材Phosphorが、期末成績を事前調整後で0.71〜1.30SD押し上げた(統計学入門・2026年春・履修者の90.2%が自主利用)。
- 読書実行率は約10%から48〜76%へ上昇。読ませる戦いでの大勝利。
- ただし効果が出たのは自由記述の設問だけ。組み込みAIチャットは一学期で72件しか使われず、学習効果への寄与はほぼゼロ。
- 効いた正体はアクティブ・リコール(検索練習)。AIの貢献は「自由記述採点を安く回せるようにしたこと」に集約される。
- 対照群なし・自己選択バイアス・小規模という限界があり、因果の断定は禁物。
🐦⬛ 編集部の視点
これ、見出しと中身のギャップがたまらない一本だ。「AI家庭教師が驚異の効果量」という煽りで拡散されたのに、論文本体を開くと作者自身が「いや、効いたのはAIとの会話じゃないんです」と冷静に書いている。この誠実さこそ読む価値がある。
私たちはついAIの新機能に目を奪われるが、教育で人を賢くしてきたのは昔から地味な検索練習だった。AIがやったのは発明ではなく、良い方法のコストを下げたこと。この「AIは魔法じゃなく、良い設計の実行コストを下げる装置だ」という視点は、教育に限らずあらゆるプロダクトに効く補助線になる。過大な期待とのズレという意味では、ザッカーバーグ「AIエージェントは期待ほど進んでいない」とも地続きだ。
あなたが次に学習アプリを選ぶとき、AIチャットの有無で選ぶだろうか、それとも「自分に書かせてくるか」で選ぶだろうか。この記事を読んだ今なら、答えは変わっているはずだ。
出典・リンク
- 出典: Jonah Bard「Balancing Efficacy and Engagement in Interactive Texts」(iTextbooks ’26) https://intextbooks.science.uu.nl/workshop2026/files/itb26_s1s2.pdf
- Hacker News での議論: https://news.ycombinator.com/item?id=48796817
- ドイツ語での分析記事(”学習効果はチャットから来ない”): https://www.drweb.de/ki-tutor-an-der-dartmouth-die-lernwirkung-kommt-nicht-aus-dem-chat/
- 比較対象:ハーバードのRCT(Kestin et al., Scientific Reports 2025): https://www.nature.com/articles/s41598-025-97652-6
- Jonah Bard 本人サイト: https://www.jonahbard.com/

コメントを残す