
要点(30秒で): DeepReinforceが、コーディング用のオープンウェイトモデル「Ornith-1.0」をMITライセンスで公開した。目玉は、モデルが解法だけでなくその解法を導く「足場(scaffold)」まで自分で書きながら鍛えられるという訓練の仕組みにある。9Bから397Bまで4サイズあり、手元のGPUで動く9Bでも同格の既存モデルを上回る——まずHugging Faceでどのサイズが自分の環境に載るかを見に行くのが最初の一手。
この記事の内容(約10分で読めます)
エージェントにコードを書かせるとき、実は一番手間がかかるのはモデルそのものではなく、その周りの「足場」だ。ツールの呼び出し方、エラーの拾い方、記憶の持たせ方、手順の組み立て——この配管を人間が一本ずつ設計してきた。
Ornith-1.0が面白いのは、そこに手を突っ込んだところにある。人が書いてきた足場を、モデル自身に書かせて、強化学習でまとめて磨く。DeepReinforceはこれを「自己足場化(self-scaffolding)」と呼んでいる。
何が公開されたのか
Ornith-1.0は、エージェント型のコーディングに特化したオープンウェイトのモデル群だ。ライセンスはMITで、地域制限もない。DeepReinforceという、これまで表舞台では目立ってこなかったチームが2026年6月末に出した。
サイズは4種類。エッジでも動く9B Dense、31B Dense、実際に動く重みが1トークンあたり約3Bに絞られる35B MoE、そしてフラッグシップの397B MoEだ。いずれも25万6千トークン(262,144)の長いコンテキストに対応する。
土台になっているのは事前学習済みのGemma 4とQwen 3.5で、どちらもApache 2.0。Simon Willison氏は「土台のライセンスとMITがちゃんと両立している」点を、以前のGemmaにあった利用規約の縛りと対比して評価している。ゼロから作ったのではなく、既存の良い土台の上に独自の訓練を乗せた、という構図だ。

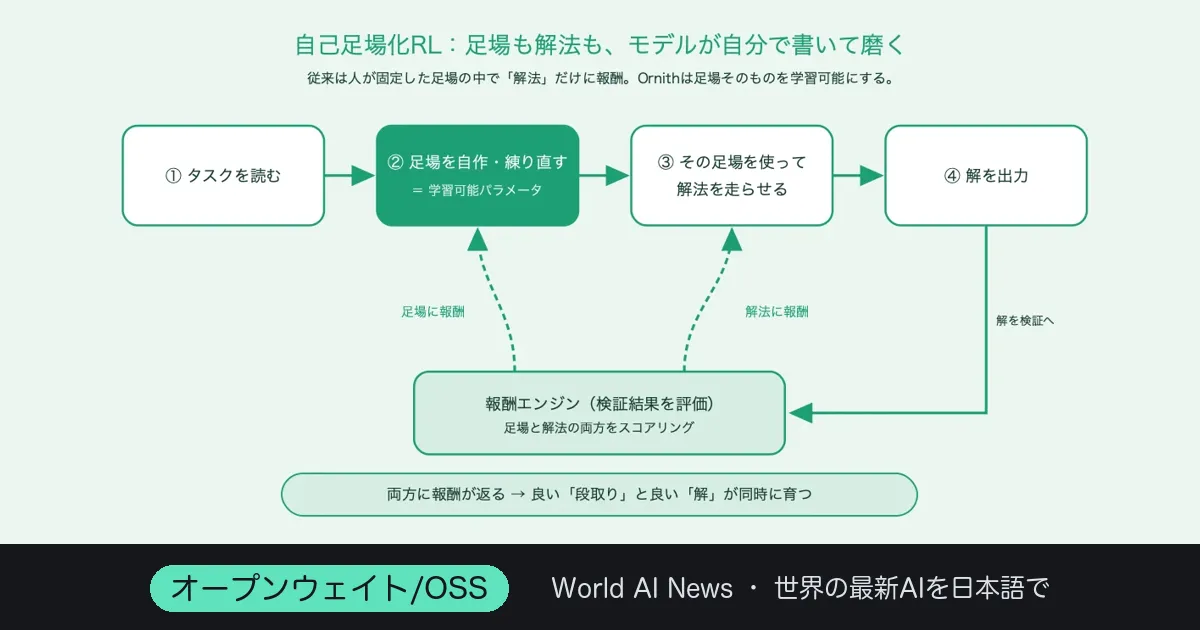
記事の核心「自己足場化RL」の仕組み——モデルが足場も解法も自分で書き、両方に報酬が返って同時に磨かれる流れ
「足場を学習する」とはどういうことか
ここが記事の核心なので、少し丁寧に書く。従来のエージェント型RLでは、モデルの外側に固定の足場——記憶・ツール・エラー処理・オーケストレーションをまとめた枠——を人間が用意し、モデルはその枠の中でだけ動いて報酬を受け取っていた。
Ornith-1.0は、その足場そのものを学習可能なパラメータとして扱う。RLの1ステップの中で、モデルはまずタスクを読んで自分用に足場を練り直し、次にその足場を使って解法を走らせる。そして足場と解法の両方に報酬が返る。だから、より良い探索の筋道と、より質の高い解が同時に見つかっていく。
言い換えれば、「どう解くか」だけでなく「どういう段取りで解きに行くか」まで、モデルが自分で発明する。人間の配管職人を、訓練ループの中に取り込んでしまったわけだ。
この発想は、少し前に本媒体で紹介した自分のハーネスを書いて磨くコーディングAI、Godcoderと同じ方向を向いている。「モデルを賢くする」から「モデルが動く土俵ごと最適化する」への移行が、静かに主流化しつつある。

4サイズの性能と置き場所を一覧で——397BはOpus 4.7と互角だがOpus 4.8には未到達、そして小型ほど手法が効く
報酬ハッキングをどう防ぐか
自分で足場を書けるということは、裏を返せば「ズルの余地」も広がるということだ。テストを書き換える、隠された答えを覗く——RLのモデルはこういう抜け道をすぐ見つける。
Ornithはここに三重の防御を敷いている。第一に、環境・ツール・テストの隔離は書き換え不能な信頼境界として固定する。第二に、禁じ手(隠しファイルの読み取りや検証スクリプトの編集)を検知したら報酬をゼロにする決定論的な監視役。第三に、主たる検証器の上に凍結したLLMの審判を置き、拒否権を持たせる。
訓練の中身は、非同期のパイプライン型RLに、トークン単位のGRPO目的関数を組み合わせたもの。古くなった方策データは「staleness(古さ)重み付け」で軽く扱う、という作りだ。派手さはないが、大規模に回すための堅い設計になっている。

自分で足場を書けるからこそ必要な「三重の防御」——隔離・監視・審判の3ゲートを全部通った解だけに報酬
性能・ベンチマーク
数字を見よう。フラッグシップの397B MoEは、Terminal-Bench 2.1で77.5、SWE-bench Verifiedで82.4を記録した。SWE-bench Proは62.2、多言語版のMultilingualは78.9だ。
比較対象を並べると位置づけが見えてくる。土台のQwen 3.5-397Bは同じTerminal-Benchで53.5だったので、訓練で20ポイント以上引き上げたことになる。プロプライエタリのClaude Opus 4.7(Terminal-Bench 70.3、SWE-bench Verified 80.8)とはほぼ肩を並べる水準だ。
ただし、ここは正直に書く。より新しいClaude Opus 4.8はTerminal-Bench 85、SWE-bench Verified 87.6で、Ornithはまだ届いていない。「最先端」はあくまで“同規模のオープンモデルの中で”という但し書きが付く。誇張せず、そこを押さえておきたい。
小さいサイズこそ効いている
個人的に唸ったのは、むしろ小さい側だ。35B MoEはTerminal-Bench 2.1で64.2を出し、土台であるQwen 3.5-397B(53.5)を、はるかに小さな体で上回っている。足場ごと鍛える効き目が、サイズの不利を補って余りある、ということだ。
9B Denseに至っては、bf16でおよそ19GB、80GBのGPU1枚どころか、量子化すればもっと手軽に載る。それでTerminal-Bench 43.1、SWE-bench Verified 69.4。同格のGemma 4-31BやQwen世代の35Bに並ぶか、上回るという。
Willison氏は量子化した35Bを実際に動かし、Datasetteのコードベースを何度もツール呼び出しを重ねながら渡り歩かせて、「エージェントの足場を多数のツール呼び出しにわたってうまく回せる」と評した。恒例のペリカンのSVG描画は毎秒103トークン、絵は「少し崩れていたが分かる」程度だったという。
使いどころ・始め方
配布形式は幅広い。bf16に加えてFP8やGGUFがあり、vLLM(MoEはテンソル並列)、SGLang、Hugging Face Transformers(5.8.1以降)、GGUF版ならllama.cpp/Ollama、Unsloth Studioでも動く。
エージェント枠との相性も意識されていて、OpenAI互換APIで関数呼び出しを標準のtool_callsとして吐くため、OpenHandsやHermes Agent、OpenClawといったフレームワークにそのまま差し込める。推奨設定はtemperature 0.6、top_p 0.95、top_k 20。ただし公開ベンチの数字を再現したいならtemperatureは1.0と明記されている点は要注意だ。
自前のコーディング環境に何を据えるか迷っている人は、まずコーディングAI比較|Claude Code・Copilot・Cursorどれが最強?と読み合わせると、クラウド商用モデルとの距離感がつかみやすい。
DeepReinforceという出し手
このチームは謎が多い。だが手ぶらで現れたわけではない。前作のCUDA-L1は、対照的強化学習でCUDAカーネルを平均3.12倍、ピーク120倍まで高速化して見せた仕事で、250個の最適化カーネルを丸ごと公開している。GPUの性能を強化学習で引き出すという、Ornithと地続きの問題意識だ。
「解法を直接ひねり出すのではなく、良い版と悪い版を並べて“なぜ速いのか”を学ばせる」というCUDA-L1の発想は、今回の「足場ごと学ぶ」にそのまま繋がって見える。この系譜は、モデルの高速化という文脈ではDSpark公開、DeepSeek-V4を最大85%速くする投機デコードとも響き合う、いま最も熱いレイヤーだ。
日本・個人開発の視点
日本の開発者にとっての実利は、9Bと35Bにある。フロンティア級の397Bは国内の多くの現場では現実的な選択肢になりにくいが、80GB1枚で回る9B、量子化ならさらに軽い構成でエージェント運用が試せるなら話は別だ。
MITライセンスで、しかも土台のGemma 4/Qwen 3.5もApache 2.0——つまり社内ツールに組み込んでも法務が止めにくい。クラウドAPIにコードを送りたくない受託や、オンプレ前提の現場にとって、この「足場ごと鍛えた軽量モデル」は現実の武器になりうる。まずは自分のリポジトリで、雑用の自動化から当ててみる価値がある。
要点まとめ
- DeepReinforceがコーディング特化のオープンウェイト「Ornith-1.0」をMITで公開。9B/31B/35B MoE/397B MoEの4サイズ、25万6千トークン対応。
- 目玉は「自己足場化RL」。モデルが解法とその足場(scaffold)を同時に書き、両方に報酬を返して磨く。土台はGemma 4とQwen 3.5。
- 397BはSWE-bench Verified 82.4、Terminal-Bench 77.5でClaude Opus 4.7と互角。ただしOpus 4.8にはまだ届かず、SOTAは「同規模のオープンモデル内」限定。
- 35Bが土台の397Bを上回るなど、小型ほど手法の効きが目立つ。9Bは80GB GPU1枚で動く。
- vLLM/SGLang/Ollama等に対応し、OpenHandsやOpenClawへ差し込み可能。ベンチ再現時のtemperatureは1.0。
🐦⬛ 編集部の視点
このニュースがじわじわ効いてくるのは、「賢いモデルを作る」競争の隣に、「モデルが働く段取りごと自動で最適化する」競争がくっきり立ち上がってきたからだ。Godcoderもそうだったが、いま面白い人たちは揃って、モデルの外側にある“配管”を学習対象に引きずり込もうとしている。
そして地味に重要なのが、その効果が小型モデルで一番はっきり出ていること。パラメータを盛って殴る路線とは別に、手法で殴る路線が、手元のGPUに降りてきている。397Bの数字に見とれるより、9Bと35Bを自分のリポジトリで動かしてみたときにこそ、この変化の手触りが分かるはずだ。あなたなら、まずどのタスクをこれに任せてみる?
出典・リンク
- 出典: https://github.com/deepreinforce-ai/Ornith-1
- DeepReinforce公式ブログ「Ornith-1.0: Self-Scaffolding LLMs for Agentic Coding」: https://deep-reinforce.com/ornith_1_0.html
- MarkTechPost「DeepReinforce Releases Ornith-1.0」: https://www.marktechpost.com/2026/06/25/deepreinforce-releases-ornith-1-0-an-open-source-coding-model-family-that-learns-its-own-rl-scaffolds/
- Simon Willison「Ornith-1.0」: https://simonwillison.net/2026/Jun/29/ornith/
- TestingCatalog「DeepReinforce releases Ornith-1.0」: https://www.testingcatalog.com/deepreinforce-releases-ornith-1-0-open-source-coding-models/
- 前作CUDA-L1(DeepReinforce): https://deepreinforce-ai.github.io/cudal1_blog/

コメントを残す